繁体 Windows 环境下 VBA 编写:VBE 编码问题与解决方案
结论先行
在繁体中文(台湾地区)Windows 环境下编写 VBA,VBE 编辑器有以下硬性事实:
- VBE 只接受繁体中文。代码窗口、字符串常量、注释遵循系统 ANSI 代码页 CP950(Big5),不是 UTF-8,也没有任何配置项能改成 UTF-8 源码模式。
- 简体中文会乱码。简体字中不在 Big5 字符集内的字(GBK 特有字),粘贴进 VBE 后直接显示为
?或乱码。 - 繁体注释直接复制粘贴进 VBE,也会乱码。因为复制来源的文件如果没有被按 CP950 正确解码,剪贴板里拿到的就是乱码字符,粘贴自然还是乱码。
- 正确做法:新建一个 txt 文档,用 WordPad(写字板)/ Word / VS Code 选择 CP950 编码,或用 Notepad++ / Notepad3 按编码打开,先把内容粘贴进这个文档(让字节被正确解码成 Unicode),再复制,然后粘贴进 VBE,才正常。注意:用记事本(Notepad)打开再复制粘贴是不行的——繁体环境实测会乱码(详见下文)。
一句话:不是「繁体字」本身的问题,而是「来源文件的字节有没有被按 CP950 正确解码」的问题。
剪贴板里到底是什么:复制正常 ≠ 粘贴正常
这是大家困惑最多的地方:复制的时候,屏幕上明明显示的是正常的繁体,粘贴进 VBE 却变成了乱码;反过来,从 VBE 里复制出来的繁体,粘贴到别处也乱码。要理解这个现象,必须看剪贴板内部到底存了什么。

剪贴板里同时存放两份格式副本:
- Unicode 层(
CF_UNICODETEXT):UTF-16LE 字符数据。复制时,来源程序把自己内存里的 Unicode 字符原样放进这一层。你屏幕上看到的就是这一层——它正常,说明 Unicode 层正常。 - ANSI 字节副本(
CF_TEXT):来源程序额外生成的一份字节,按来源程序所在系统的 ANSI 代码页编码(繁体系统 = CP950)。这是 Windows 为兼容老程序保留的格式,复制时总会被同时生成。
粘贴时,目标程序二选一读取:
- 现代程序(WordPad、VS Code、现代网页、聊天工具)读 Unicode 层 → 字符原样进入,正常。
- 老程序 / 部分老控件读 ANSI 副本 → 按目标系统代码页解码。
乱码就出在第二种情况:
- 来源是繁体系统 → ANSI 副本是 CP950 字节
- 目标是简体系统 → 用 GBK 去解 CP950 字节 → 乱码(
砼珍□□代刚爹秆) - 反之亦然:简体来源的 ANSI 副本是 GBK 字节,被繁体系统用 CP950 解 → 乱码
所以「复制正常、粘贴乱码」的完整解释是:
你看到的「正常」来自剪贴板的 Unicode 层;你粘出来的「乱码」来自剪贴板的 ANSI 字节副本,加上目标代码页不匹配。来源显示正常 ≠ 粘贴结果正常——结果取决于目标程序读哪一份,以及双方代码页是否一致。
从 VBE 复制出来也是一样:
- VBE 复制时同样放两份:Unicode 层(你屏幕看到的正常繁体)+ ANSI 副本(按系统代码页生成,繁体系统就是 CP950 字节)。
- 粘贴到读 Unicode 层的现代程序 → 正常;
- 粘贴到读 ANSI 副本的旧环境(老控件、老式上传/保存通道)→ 繁体系统的 CP950 字节到了简体环境被按 GBK 解 → 乱码。
还有一个叠加因素:如果 VBE 代码窗口里本身已经是 ?(当初粘贴时就已经乱码),那 Unicode 层里存的就是 ? 本身——再怎么复制、贴到哪里都是 ?,因为字符在进 VBE 的那一刻就已经丢失了。
从 VBE 往外拿代码的正确做法(导出 .bas):
在 VBE 的模块窗口里右键(或菜单「文件 → 导出文件」)→ 保存为 .bas。导出的 .bas 是按系统代码页(繁体 = CP950)编码的字节文件。
实测可行:用记事本打开导出的 .bas → 显示正常 → 复制出来 → 内容正常。这里记事本读的是「文件字节」——.bas 的字节就是 CP950,记事本按系统 ANSI 代码页解码,读取路径正确,所以能正常复制出来。
注意区分「记事本的两个场景」:
- 记事本打开
.bas读取/复制 → 可以(实测 ✓):字节是 CP950,记事本按 ANSI 解码,读出来就是对的; - 记事本当中转站(新建 txt 粘贴再复制进 VBE)→ 不行(实测 ✗):粘贴/复制路径会做编码形态转换,中转不可靠。
所以结论是:记事本可以「读」,不能「中转」。要粘贴进 VBE,还是走 WordPad / Word / VS Code / Notepad++ / Notepad3 中转。
安全结论:
- 现代编辑器之间复制粘贴(双方都读 Unicode 层)→ 永远正常。
- 乱码只发生在两种情况:① 某一边读了 ANSI 副本且代码页不匹配;② 字符在进入剪贴板之前就已经损坏(如 VBE 里已是
?)。 - 记事本之所以实测「不行」,正是因为它的复制路径会额外生成按系统代码页转换的字节副本,而 VBE 的粘贴读取路径与之不匹配——中转请用 WordPad / Word / VS Code / Notepad++ / Notepad3。
- 中转文件方案之所以可靠,正是因为:先让字节按 CP950 被正确解码成 Unicode(屏幕正常),再用现代编辑器之间传递(读 Unicode 层),最后粘贴进 VBE 时拿到的就是正确的 Unicode 字符——绕开了所有 ANSI 副本和代码页匹配的坑。
为什么会这样:编码原理
文本的两种形态:内存里的 Unicode 与文件里的字节
任何文本在程序内存里都是 Unicode 字符,但保存到文件时必须按某种编码(代码页)转换成字节。打开文件时再按某种编码把字节还原成字符。
关键点是:文件本身不记录自己是什么编码(除非带 BOM)。同一个字节串,用什么编码去解,结果完全不同:
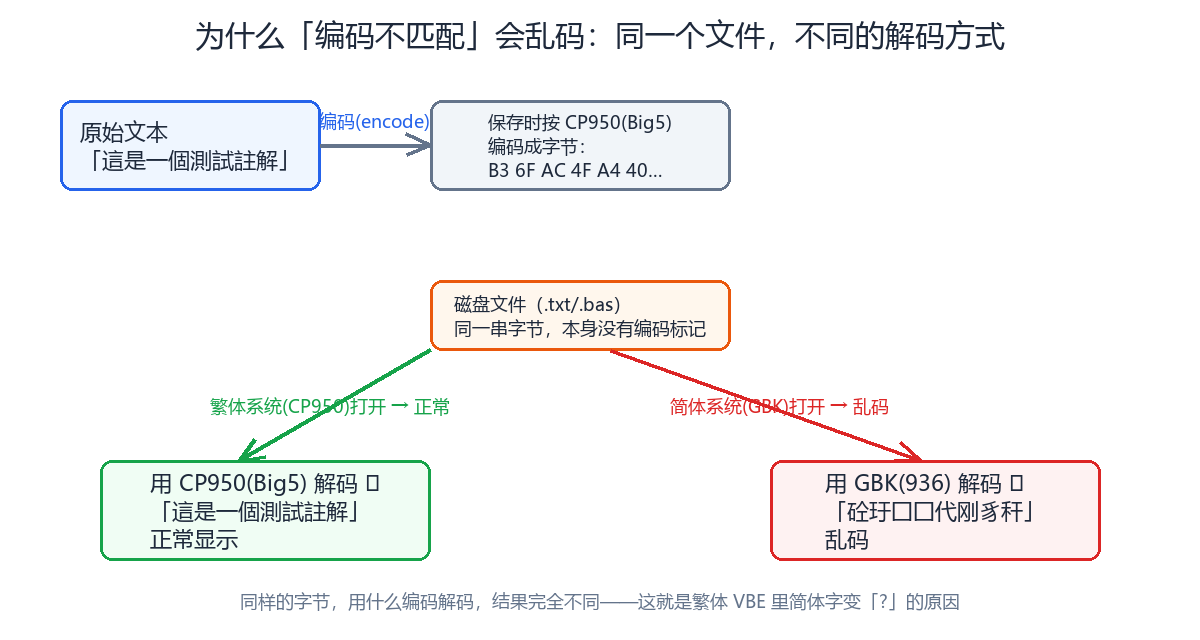
上图是本机的真实演示:一份繁体文本按 CP950 编码保存为文件后:
- 繁体系统(ANSI 代码页 = CP950)打开 → 正常显示
- 简体系统(ANSI 代码页 = GBK/936)打开 → 乱码(
砼珍□□代刚爹秆)
下面的截图是同一份 CP950 文件在简体系统记事本里的真实效果——GBK 去解 Big5 字节,注释行全部乱码:
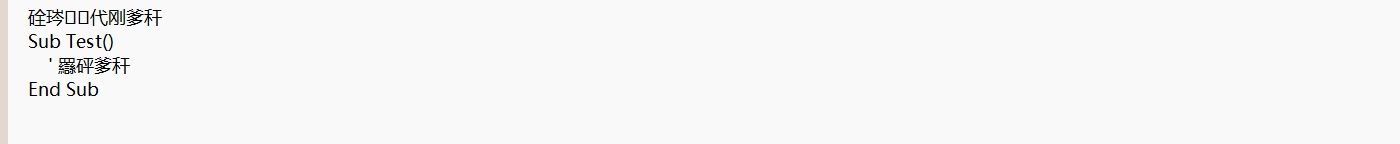
把方向反过来,就是繁体系统里的场景:简体系统写出的 GBK 字节,拿到繁体系统被 Big5 解码 → 乱码。原理完全相同,只是方向相反。
VBE 的原生限制
VBE 是 1990 年代的架构,代码窗口、字符串、注释全部遵循系统 ANSI 代码页:
- 繁体系统 → CP950(Big5)
- 简体系统 → GBK(936)
VBE 没有「另存为 UTF-8」之类的选项,也不接受 UTF-8 源码直接粘贴(UTF-8 字节流会被按 ANSI 逐字节解码,产生大量乱码字符)。所以代码层面无法绕过——要么用系统代码页内能表示的字符(繁体),要么别把文本硬编码在代码里(放到工作表单元格,单元格是 Unicode,不受代码页约束)。
各种软件、各种状态的编码形态
用本机实测,看看不同编辑器对同一份 CP950 文件的处理差异:
记事本(Notepad)—— ⚠️ 不能用作中转,实测不行
先看显示层面:无 BOM 的文件按系统 ANSI 代码页解码。简体系统上打开 CP950 文件 → 乱码(见上图);繁体系统上打开 GBK 简体文件 → 同样乱码。
但更关键的是:记事本不能作为「中转再复制进 VBE」的工具,这是繁体环境实测得出的结论。把内容粘贴进记事本、再从记事本复制粘贴进 VBE,结果是乱码,不可行。原因有两层:
- 记事本没有「指定编码打开」的选项,无法强制按 CP950 处理;
- 新版记事本默认按 UTF-8 语义处理文本,粘贴/复制路径会发生编码形态转换,中转不可靠。
要用中转方案,请用下面几个工具(都可选 CP950 或自动按系统 ANSI 处理)。
WordPad(写字板)—— ✓ 实测可以
繁体系统自带的写字板(WordPad)打开文本文件时按系统 ANSI 代码页(CP950)读取,显示正常;复制时按 Unicode 提供给剪贴板,再粘贴进 VBE 正常。这是繁体环境实测可行的中转工具,且不需要任何编码设置——新建 txt → 用 WordPad 打开 → 粘贴 → 复制 → 粘贴进 VBE 即可。
VS Code
VS Code 默认按系统语言猜测编码,简体系统上把 CP950 文件按 GBK 打开,注释行变成乱码方块:
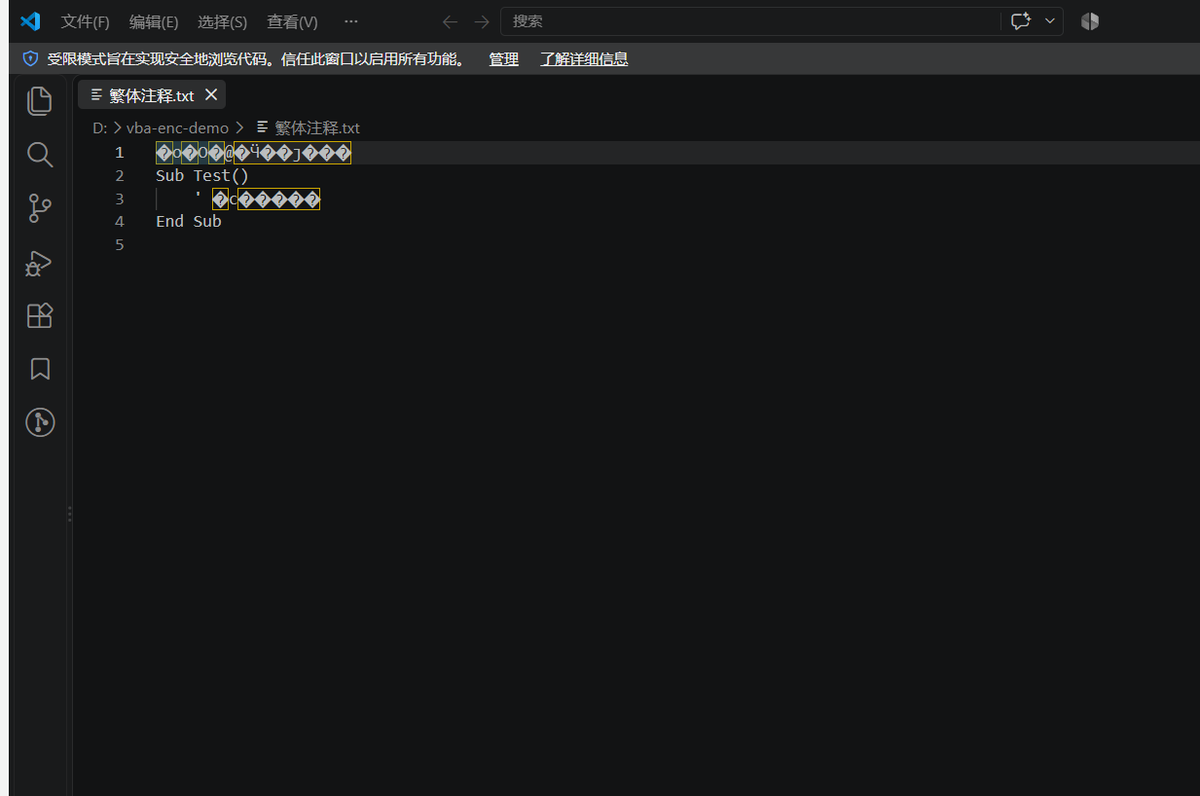
解决办法:命令面板(Ctrl+Shift+P)→「通过编码重新打开」→ 选 Traditional Chinese (Big5 / CP950):
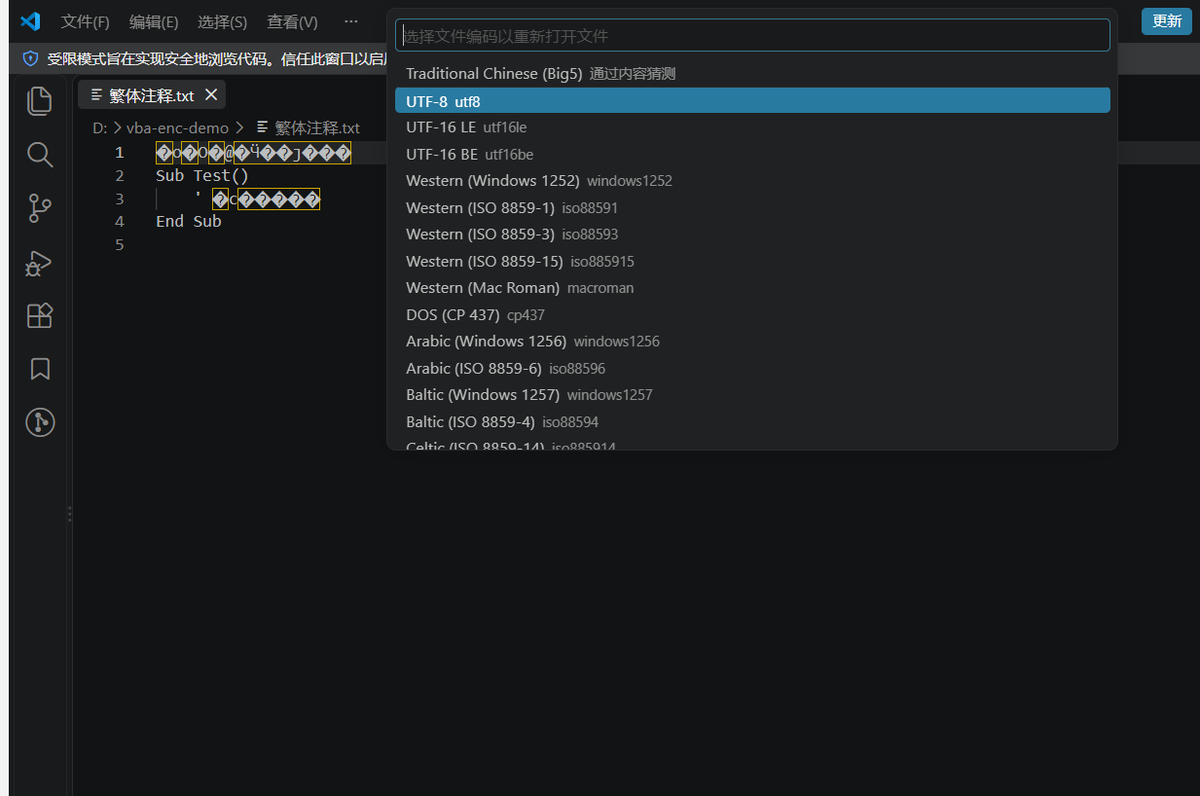
选 CP950 后,繁体注释全部正常显示:
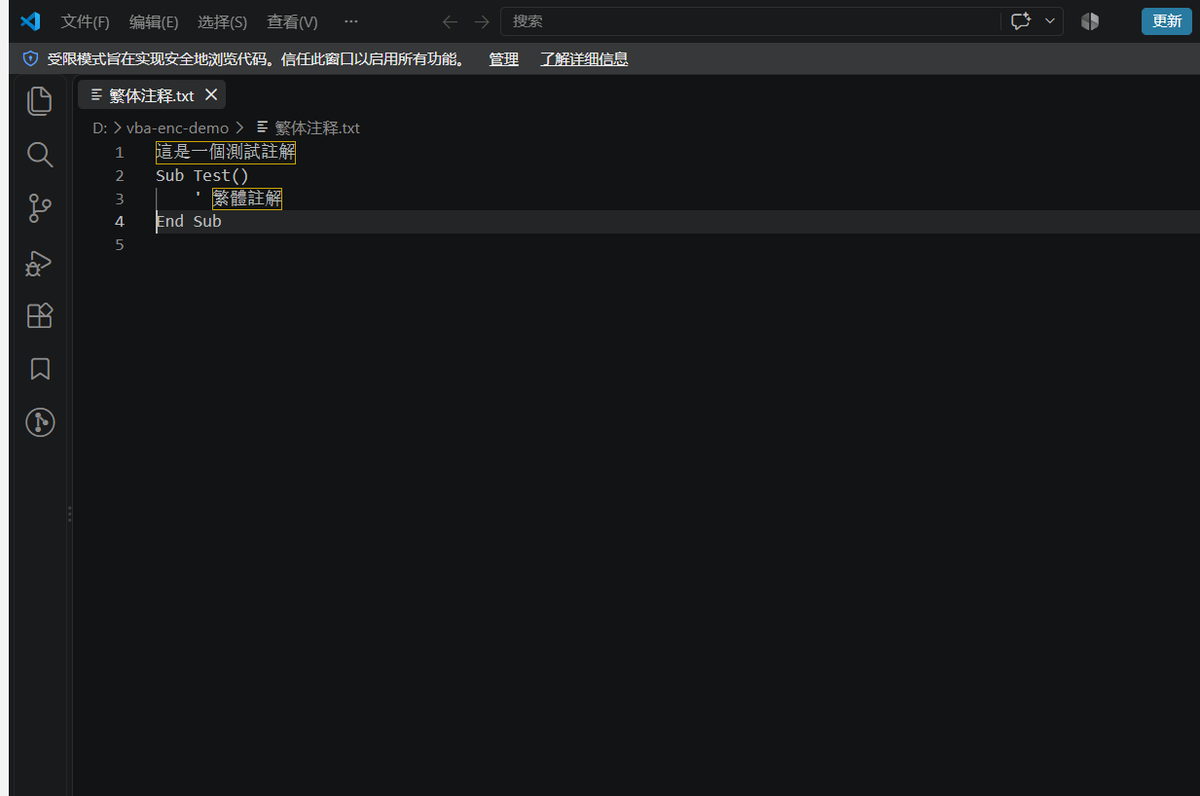
VS Code 的编码选择器里能看到「Traditional Chinese (Big5)」,对应代码页 950——这就是我们要选的编码。
Notepad++ / Notepad3
Notepad++ 的编码自动检测能力强,同一份 CP950 文件打开即自动识别为 Big5,正常显示,无需手动设置:
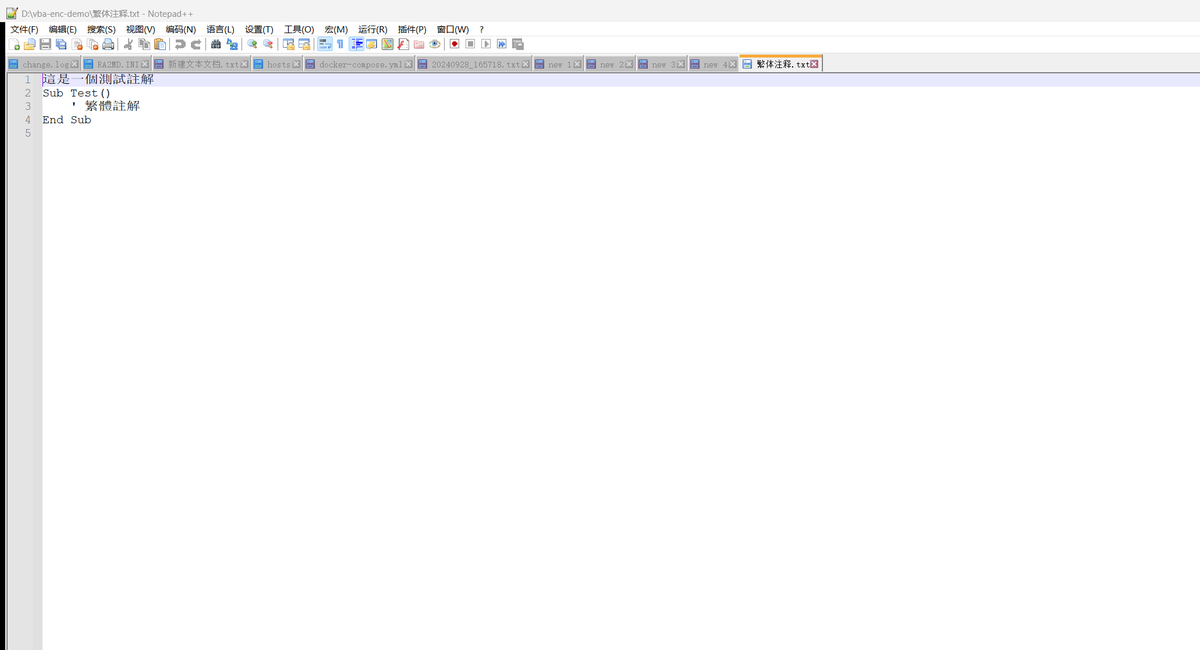
如果打开仍是乱码,用菜单「编码 → 字符集 → 中文 → Big5」手动切换即可。Notepad3 同属此类。
Word
Word 打开文本文件时可指定编码(文件 → 打开 → 选择文件 → 编码),选择繁体中文(Big5)即可正常。这也是结论里推荐的中转工具之一。
VBE(示意)
VBE 本身没有编码选项,行为如下(图为示意——在自己电脑上是简体环境,无法真实复现繁体 VBE,故用示意图呈现):
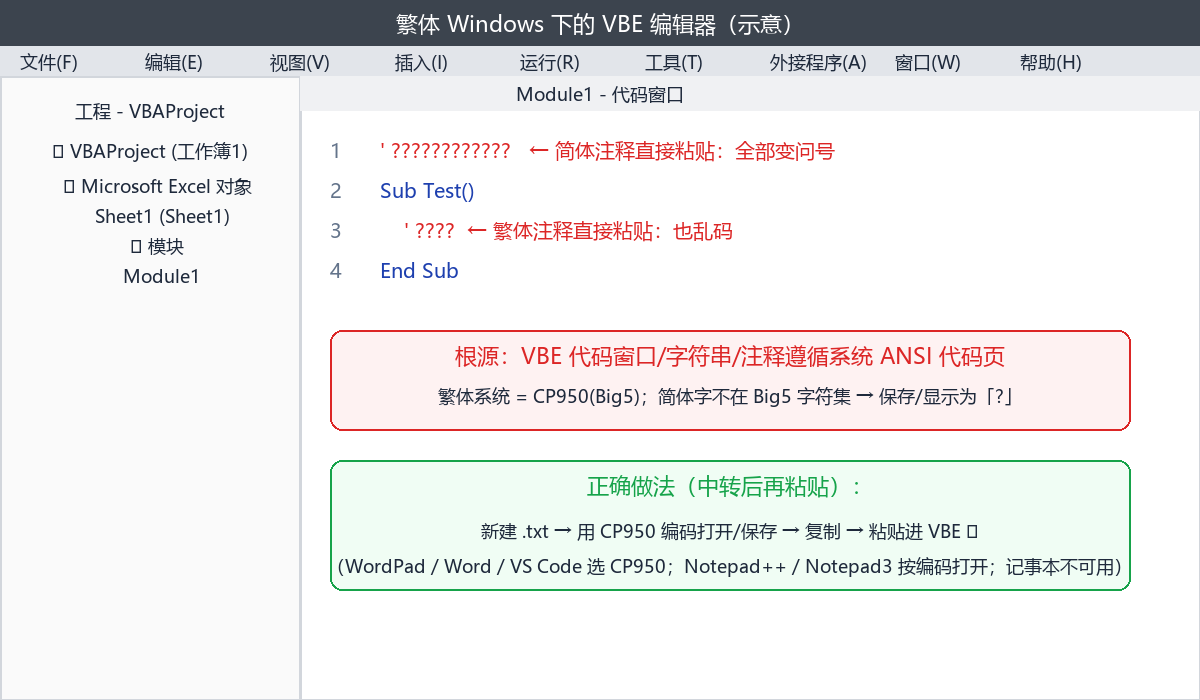
- 简体注释直接粘贴 → 全部变
? - 繁体注释从未正确解码的来源复制 → 也乱码
- 经 CP950 正确打开的 txt 中转后再复制粘贴 → 正常
推荐的完整流程
1
2
3
4
5
6
7
8
9
10
11
12
目标:把一段带中文注释的 VBA 代码安全放进繁体系统的 VBE

1. 新建一个 .txt 文件
2. 用以下任一方式打开,并确认编码为 CP950(Big5):
   - WordPad(写字板):直接打开即可(按系统 ANSI/CP950 读取,实测可行 ✓)
   - Word:打开时选「繁体中文 (Big5)」编码
   - VS Code:右下角/命令面板 → 通过编码重新打开 → Traditional Chinese (Big5)
   - Notepad++ / Notepad3:编码 → 字符集 → 中文 → Big5(或打开即自动识别)
   - ⚠️ 记事本(Notepad):**不要用**——实测粘贴进记事本再复制进 VBE 会乱码
3. 把代码粘贴进这个 txt,保存(保持 CP950)
4. 在 txt 里 Ctrl+A 全选、复制
5. 到 VBE 里粘贴 —— 繁体中文正常显示
VS Code 的 VBA 插件
推荐 XVBA - Live Server VBA(local-smart.excel-live-server,23 万+ 安装)。
XVBA 把 Excel / Access 的 VBA 工程直接接到 VS Code:
- Import VBA:一键把 Excel/Access 里的全部模块拉成
.bas/.cls/.frm文件到工作区——可以直接点击读取/编辑这些.bas文件; - Live Server:在 VS Code 里保存
.bas,只推送改动的那一个文件,Excel 里立即生效; - Export Changed VBA:随时手动把改过的文件推回 Excel,无需重载整个工程;
- 附带 IntelliSense 自动补全、代码片段、宏运行、Ribbon 设计等能力。
安装:VS Code 里 Ctrl+P → ext install local-smart.excel-live-server 下载地址:https://marketplace.visualstudio.com/items?itemName=local-smart.excel-live-server
配合本文的编码方案:在 VS Code 打开 .bas 时,通过「通过编码重新打开」选 Traditional Chinese (Big5 / CP950),编辑、保存、复制都按 CP950 语义走,再配合 XVBA 直接读 .bas / 推回 Excel。
工作流建议:用 XVBA 在 VS Code 里直接读写 .bas(按 CP950 编码)→ 需要粘贴时复制 → 粘贴进 VBE,既避开 VBE 的编辑体验问题,又不踩编码坑。
附:繁体环境 VBA 代码规范(厂区实践总结)
以下是在厂区繁体版 Office + 中文(台湾)地区设定环境下做 Excel 工具(IE 报表、UPPH、良率、工时、SOP 工具)踩坑后的硬性规范:
- 代码注释、硬编码字符串,只用繁体文字。避免 Big5 缺字乱码。
WorksheetFunction固定用英文函数名(如Application.WorksheetFunction.VLookup)。写本地化中文名(如「垂直尋找」「總和」)会直接报错。- 业务逻辑禁止比对
MonthName/WeekdayName返回的文字。繁体环境下它们返回繁体中文,应只用Month()/Weekday()的数字判断。 - 外部日期字符串不用
CDate直接解析(跟随系统短日期格式,易错)。用Split+DateSerial(y, m, d)构造日期序列号。 - 跨环境分发模块,不要依赖 VBE 原生导出
.bas。VBE 导出.bas用系统 ANSI 代码页(繁体 = CP950),繁体导出给简体 VBE 导入会乱码;改用文件/文本等载体传递代码。(注:导出.bas后自己用记事本打开再复制是可以的,见剪贴板章节;本条针对的是把.bas直接交给另一个 VBE 导入的跨环境场景。) - 跨环境交付带工程密码的 VBA 工程(xlsm)存在加载/密码校验风险;旧格式
.xls的二进制工程兼容性更差。交付前建议移除工程密码。 StrConv可做繁简转换(StrConv(文字, vbSimplifiedChinese)/StrConv(文字, vbTraditionalChinese)),但只转换字符串内容,救不了源码里已经乱码的硬编码。- VBE 语法关键字永远是英文(
If/For/Dim/Function等),不受 Office 界面语言影响,不存在中文关键字版本。 - 业务文本不要硬编码在代码字符串里,放到工作表单元格读取——单元格是 Unicode,不受 CP950 约束。
小结
- 繁体系统 VBE 的编码基线是 CP950(Big5),这是根源。
- 乱码 = 字节与代码页不匹配,剪贴板本身不背锅。
- 正确姿势:txt + 用 WordPad / Word / VS Code / Notepad++ / Notepad3 按 CP950 打开 → 复制 → 粘贴进 VBE(记事本不行,实测会乱码)。
- 长期看:注释/字符串统一繁体、文本放单元格、跨环境用文件而非
.bas传递,能从根上避开大部分编码坑。